Whisper语音字幕识别
本文使用以下音频作为流程的操作对象
一、视频音频下载
1.1.视频音频网站
BiliBili、Youtube、X(Twitter)、TikTok
1.2.下载工具
yt-dlp、DownKyi、唧唧Down
1.3.下载流程
yt-dlp命令行、DownKyi和唧唧Down复制链接设置下载格式
二、视频音频处理
2.1.处理工具
FFmpeg命令行、QuickCut(FFmpeg中文UI)、Ultimate Vocal Remover、Shotcut、ShanaEncoder、PR、AU
个人常用QuickCut、Ultimate Vocal Remover、Shotcut、ShanaEncoder
2.2.视频处理
Shotcut剪辑,ShanaEncoder视频字幕压制,QuickCut快速分割处理
2.3.音频处理
QuickCut快速分割处理、格式转换,Ultimate Vocal Remover去除背景音乐保留并增强人声
三、音频识别
3.1.Whisper工具
基于Whisper的桌面应用,github项目
https://github.com/Const-me/Whisper
GitHub - Const-me/Whisper: High-performance GPGPU inference of OpenAI’s Whisper automatic speech recognition (ASR) model


3.2.模型选择
储存在HuggingFace的处理模型
https://huggingface.co/ggerganov/whisper.cpp/tree/main
ggerganov/whisper.cpp


3.3.识别流程
选择加载需要的模型,选择目标语言,选择处理完毕的音频文件,选择输出字幕格式,点击Transcribe按钮,等待语音识别完成
附录
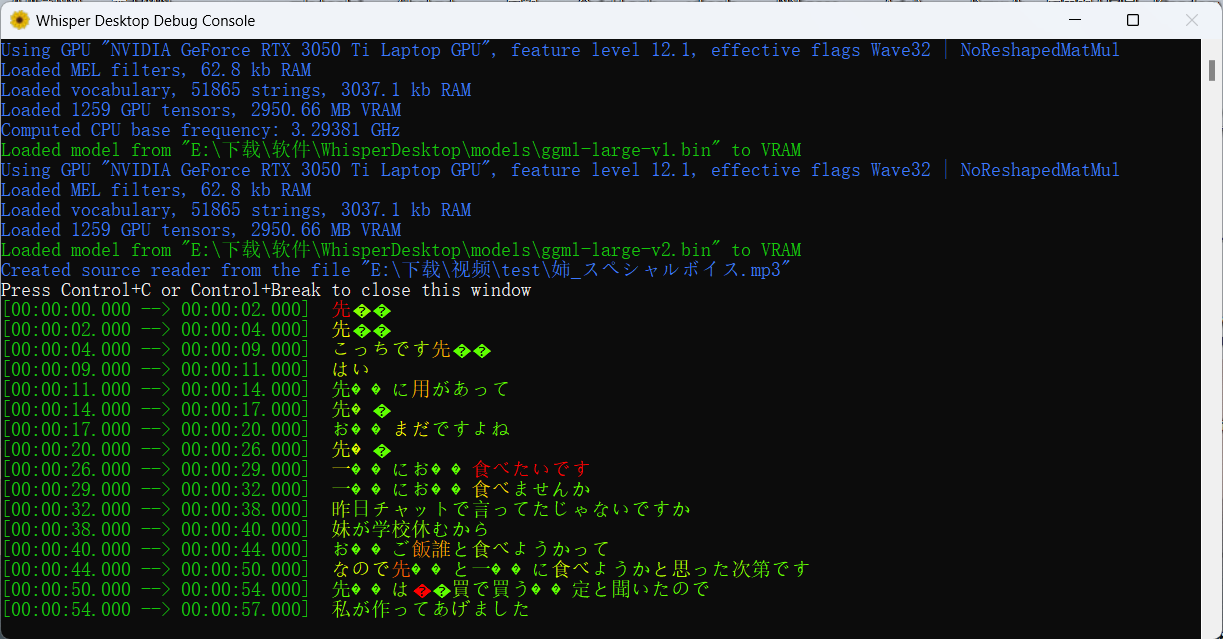
识别结果信息




Whisper语音字幕识别
https://www.sltlala.top/2023-11/bc6b3b97f214/